Diferencias entre aprendizaje supervisado y no supervisado

El aprendizaje automático, o machine learning, es la rama de la inteligencia artificial que permite a los sistemas aprender patrones a partir de datos para realizar predicciones o tomar decisiones sin ser programados explícitamente para cada tarea. Dentro de este ecosistema, existen diferentes enfoques dependiendo de cómo se presenten la información y el objetivo que se persiga.
Las dos metodologías fundamentales son el aprendizaje supervisado y el aprendizaje no supervisado. La diferencia esencial radica en la presencia o ausencia de etiquetas en los datos de entrenamiento. Mientras que el primero requiere un guía que indique la respuesta correcta, el segundo busca estructuras ocultas por sí mismo. Comprender estas distinciones es crucial para determinar qué técnica es la adecuada según el problema que se intente resolver.
Aprendizaje supervisado: El modelo guiado
El aprendizaje supervisado funciona bajo la premisa de que el sistema dispone de un conjunto de datos previamente etiquetados. Esto significa que cada dato de entrada tiene asociada una respuesta correcta o una categoría definida. El algoritmo analiza estos ejemplos y aprende la relación matemática o lógica entre la entrada y la salida.
Cuando el modelo se enfrenta a datos nuevos que nunca ha visto, utiliza los patrones aprendidos durante el entrenamiento para predecir la etiqueta correspondiente. Este proceso es análogo a un estudiante que resuelve ejercicios con un libro de respuestas al final; el alumno intenta el problema y luego verifica si su resultado es correcto, ajustando su razonamiento hasta que el error se minimiza.
Existen dos tipos principales de tareas en este enfoque:
- Clasificación: El objetivo es asignar el dato a una categoría discreta. Por ejemplo, determinar si un correo electrónico es spam o no.
- Regresión: El objetivo es predecir un valor numérico continuo. Por ejemplo, estimar el precio de una vivienda basándose en sus metros cuadrados y ubicación.
Aprendizaje no supervisado: El descubrimiento de patrones
A diferencia del anterior, el aprendizaje no supervisado trabaja con datos que no tienen etiquetas. El sistema no conoce la respuesta correcta y no tiene un objetivo predefinido sobre qué debe encontrar. En su lugar, el algoritmo analiza la estructura inherente de los datos para encontrar similitudes, diferencias o anomalías.
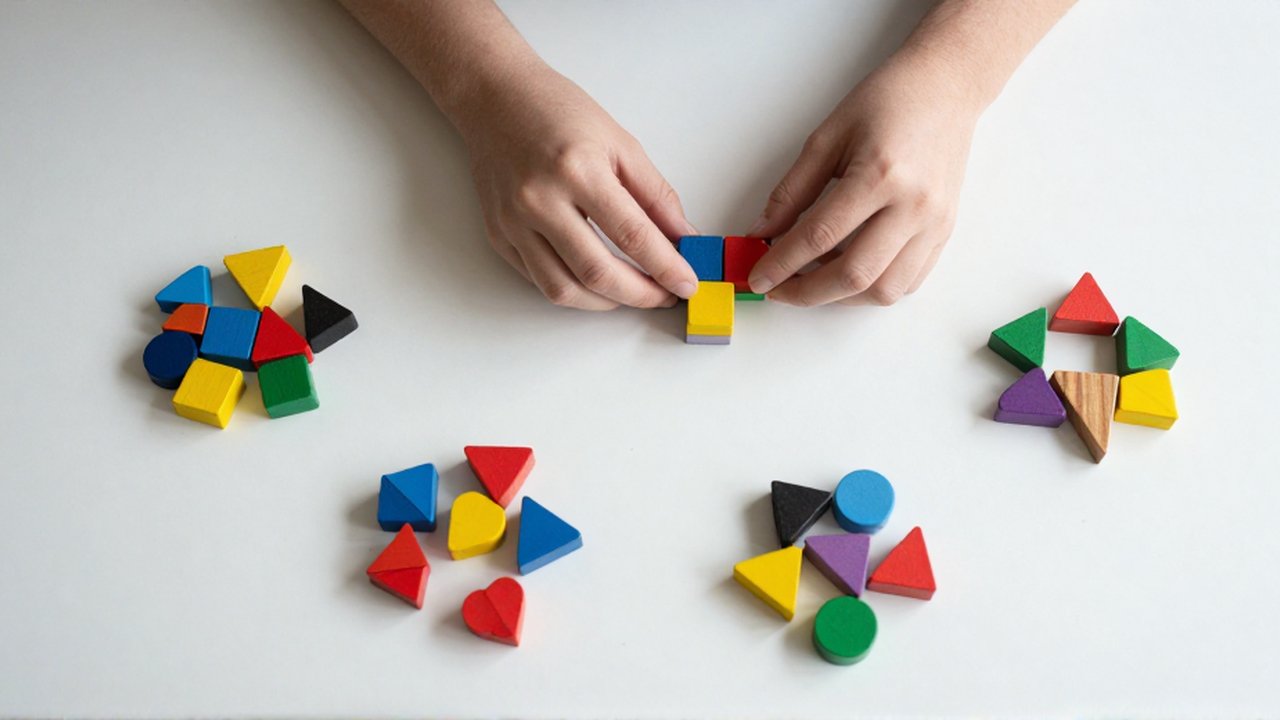
Su propósito no es predecir una etiqueta, sino describir la organización de la información. Es similar a darle a una persona un montón de piezas de colores y formas diversas sin instrucciones; la persona empezará a agrupar las piezas por color o por tamaño basándose únicamente en sus características visuales.
Las aplicaciones más comunes de este método son:
- Agrupamiento (Clustering): Dividir la base de datos en grupos con características similares. Por ejemplo, segmentar la base de clientes de una empresa según sus hábitos de consumo.
- Asociación: Identificar reglas que describen winch relaciones entre variables. Por ejemplo, detectar que las personas que compran pan suelen comprar también mantequilla.
- Reducción de dimensionalidad: Simplificar la complejidad de los datos eliminando variables redundantes sin perder la información esencial.
Comparativa de características principales
Para diferenciar ambos enfoques, es útil observar cómo operan en dimensiones críticas:
- Datos de entrada: El supervisado requiere datos etiquetados (input + output), lo que suele implicar un esfuerzo humano previo para clasificar la información. El no supervisado utiliza datos brutos (solo input).
- Objetivo: El supervisado busca predecir resultados futuros basándose en el pasado. El no supervisado busca descubrir la estructura interna o patrones ocultos en los datos actuales.
- Evaluación: En el supervisado es sencillo medir la precisión comparando la predicción con la etiqueta real. En el no supervisado, la evaluación es más subjetiva y depende de cuán útil o coherente sea el grupo o patrón encontrado.
- Complejidad computacional: El aprendizaje no supervisado puede ser más costoso computacionalmente al tener que analizar todas las interacciones posibles entre los datos para encontrar similitudes.
Preguntas frecuentes sobre la elección del modelo
¿Se puede combinar el aprendizaje supervisado y no supervisado?
Sí, existe el aprendizaje semi-supervisado. En este caso, se utiliza una pequeña cantidad de datos etiquetados y una gran cantidad de datos no etiquetados. El modelo utiliza los datos sin etiqueta para entender la estructura general y los datos etiquetados para refinar la precisión de las predicciones.
¿Cuál es más preciso?
La precisión no depende del tipo de aprendizaje, sino de la calidad de los datos y la elección del algoritmo. El aprendizaje supervisado suele ser más preciso para tareas específicas de predicción, mientras que el no supervisado es la única opción viable cuando no se conocen las categorías de antemano o no se dispone de etiquetas.
¿Cuándo elegir el aprendizaje no supervisado?
Se debe optar por este método cuando el objetivo es la exploración de datos, la detección de anomalías o cuando se quiere generar una hipótesis inicial que luego pueda ser validada mediante un proceso supervisado.
Deja una respuesta
Entradas relacionadas